Parquet
Progetto Apache usato comunemente nei datalake e lakeshouses. Questo formato di dati non è human readable ed è ottimizzato per memorizzare e processare dati anche con tipi di dato annidati. Inoltre è molto efficiente nella compressione e schemi di codifica (encoding).
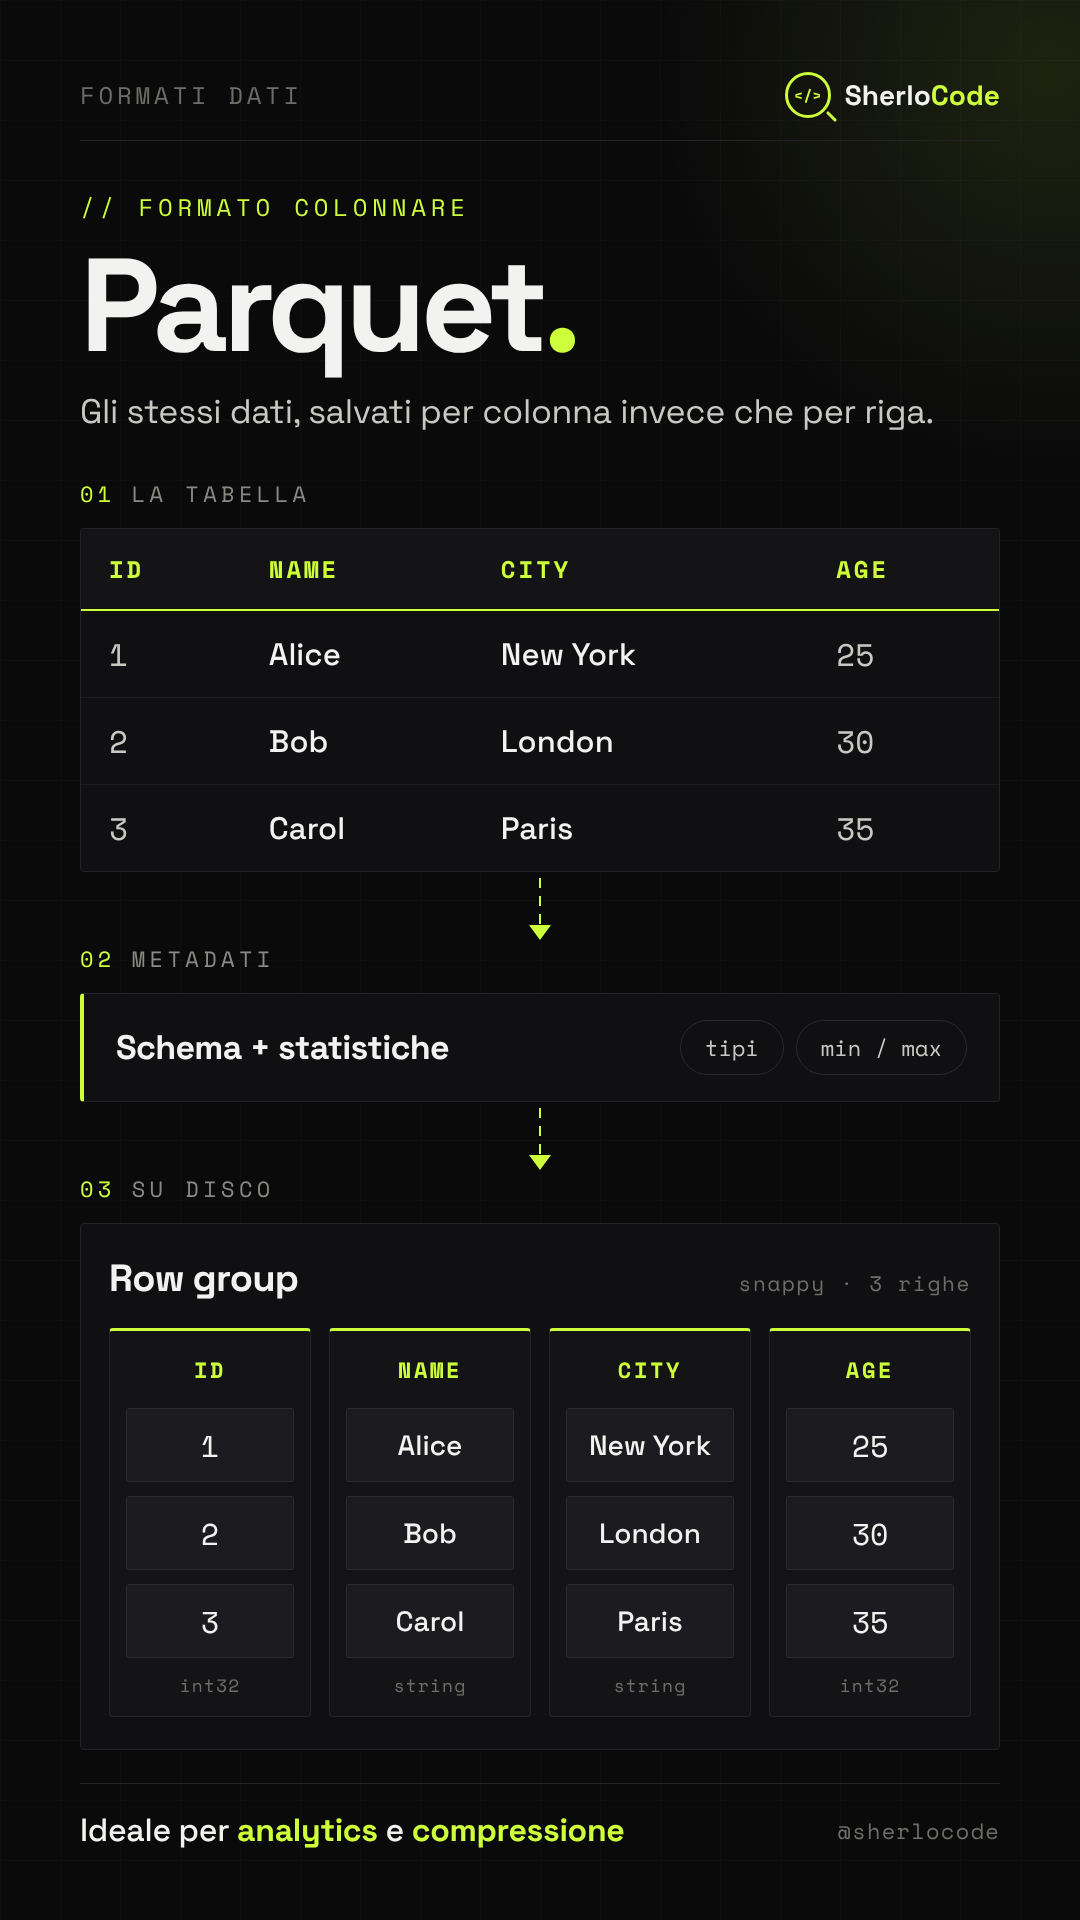
I dati all’interno di un file Parquet hanno essenzialmente 3 livelli al suo interno
- rowgroup
- column chunk
- pagine
File Parquet
├── Row Group 1  (es. righe 1 – 1.000.000)
│   ├── Column chunk "id"     → pagine
│   ├── Column chunk "nome"   → pagine
│   └── Column chunk "sesso"  → pagine
├── Row Group 2  (righe 1.000.001 – 2.000.000)
│   ├── Column chunk "id"
│   ├── Column chunk "nome"
│   └── Column chunk "sesso"
└── ...
└── Footer (metadati: schema, posizione e statistiche di ogni row group)
i rowgroup è un blocco di righe consecutive, al suo interno ogni colonna della sorgente ha il suo column chunk che al loro interno memorizzano i valori in modo colonnare, ossia prima tutti i valori della colonna id, poi tutti i valori della colonna nome e così via. Infine i column chunk sono poi divisi in pagine che sono la più piccola unità di di compressione e lettura (comunemente di 1MB l’una).
Al fondo del file viene inserito il footer, ossia una sorta di mappa che spiega cosa c’è all’interno del file e dove si trova.
PAR1 | Row Group 1 | Row Group 2 | ... | Footer (metadati) | lunghezza footer (4 byte) | PAR1I metadati sono serializzati in formato Thrift e sono organizzati a livelli:
- Livello file
- lo schema (nomi delle colonne, tipi, nullabilità, strutture annidate)
- il numero totale di righe
- la versione e
created_by - metadati chiave-valore liberi, dove per esempio Spark o Arrow salvano il proprio schema originale
- Per ogni row group
- il numero di righe
- la dimensione in byte
- l’elenco dei column chunk
- Per ogni column chunk
- il tipo
- il codec di compressione (Snappy, ZSTD…)
- gli encoding usati (dictionary, RLE, plain…)
- l’offset nel file della pagina dizionario e della prima pagina dati
- le dimensioni compressa e non compressa
- le statistiche: min, max e numero di null
Come si decide la dimensione dei dati da mettere nel row group? Dipende dallo strumento di esportazione in Parquet, in alcuni casi va a dimensione (128 MB per row group per Spark) o per numero di righe (1 milione di righe per pandas). Questo è un paramentro che si può in ogni caso modificare ma si devono tenere a mente questi aspetti:
- Row group di grandi dimensioni / n° di righe - La compressione è migliore e si hanno meno metadati ma serve più memoria per scrivere il file
- Row group di piccole dimensioni / n° di byte - Possiamo eseguire un filtraggio più fine ed eseguire delle query che saltano interni rowgroup e sono più performanti ma in cambio abbiamo più overhead