Data lake
E’ un archivio centralizzato di grandi dimensioni che permette di memorizzare al suo interno una grande quantità di dati nel loro formato originale, infatti supporta qualsiasi formato (strutturato, semi strutturato e non strutturato). L’idea è quella di salvare quante più informazioni possibili subito per poi andare a decidere come, quali e quante usare dopo.
Data warehouse
E’ un database progettato per l’analisi e la reportistica, improntato a analizzre dei dati e non eseguire operazioni quotidiane come un normale database relazionale. Raccoglie dati da diverse fonti, li pulisce, li integra e li memorizza organizzandoli in modo che i dati siano ottimizzati per operazioni di lettura.
Data lakehouse
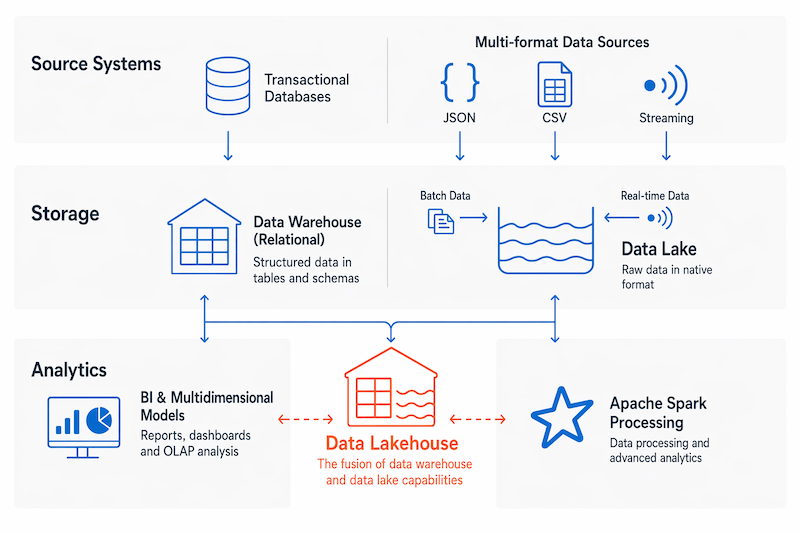
E’ un architettura che unisce i due visti prima, data lake e data warehouse. Quindi combina lo storage economico, flessibile e aperto del data lake con le prestazioni del data warehouse.
E’ stato introdotto principalmente per risolvere il problema di avere i dati in due parti diverse; un’azienda prendeva i suoi data e li portava nel data lake, dopo di ché, ne duplicava una porzione, trasformandoli e integrandoli con il data warehouse. Questo portava a duplicare dati, avere pipeline complicate e che richiedevano tempo per completare la loro esecuzione ed infine i dati soventemente non erano aggiornati perché risiedevano sul data lake e dovevano attendere la pipeline.
Modello OLAP (Online Analytical Processing)
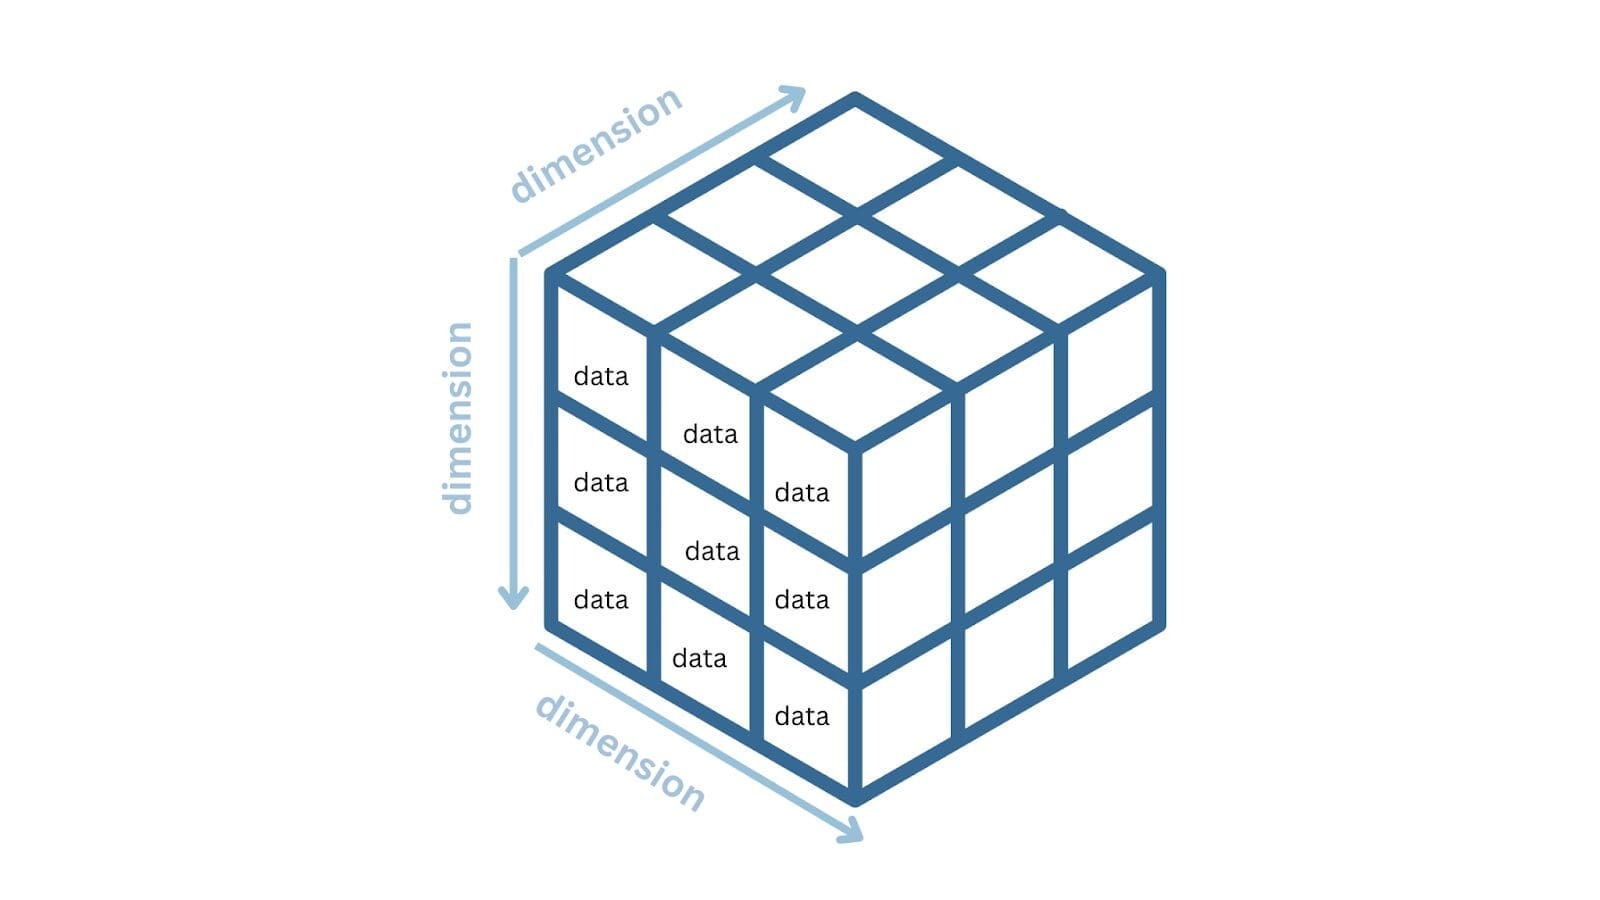
E’ una metodologia per l’organizzazione dei dati che si concentra sulla loro analisi. Tipicamente i dati vengono strutturati in righe e colonne e viene eseguita un’analisi bidimensionale, con i modelli OLAP, invece, i dati vengono organizzati in un cubo con tre dimensioni come minimo, ma se ne possono aggiungere molte di più (in questo caso di parla di ipercubo). Questo permette di analizzare un dato da più punti di vista contemporaneamente.
I concetti di base sono:
- Misure - i valori numeri da analizzare. Es: quantità venduta, margine, fatturato…
- Dimensioni - Gli assi lungo cui si analizzano le misure. Es: tempo, articolo, cliente, regione…
- Gerarchie - I dettagli all’interno di una dimensione. Es: se scegliamo come dimensione la regione abbiamo nazione - regione - provincia - comune - indirizzo
- Cubo - Sarebbe l’insieme delle misure incrociate su tutte le dimensioni. Es: La quantità venduta della tazza rossa a Londra nel marzo del 2021
Introdotti questi concetti, possiamo quindi comprendere i vari strumenti citati sopra verranno usati da diverse tipologie di utenti.
Un data scientist lavorerà direttamente con i dati salvati nel data lake per esplorarli e modellarli.
Un Data analyst userà il data warehouse per eseguire query e creare report e visualizzazioni complesse
Un utente business userà i modelli OLAP per andare a eseguire analisi sui propri dati aziendali in modo da poter estrarre informazioni utili per prendere decisioni consapevoli.
Architettura medallion
E’ un pattern che introduce 3 livelli di ingestione dei dati all’interno di un data lakehouse. Questi livelli sono:
- Bronze - vengono memorizzati i dati così come sono salvati nel sistema sorgente, senza applicare trasformazioni.
- Silver - Vengono puliti e normalizzati i dati, cancellando i duplicati e standardizzando i tipi di dato
- Gold - I dati vengono aggregati e modellati per permettere la creazione di report di analisi e visualizzazioni
Azure Data Factory

E’ un servizio Azure che permette di definire e schedulare data pipelines per trasferire e trasformare dati. Si può integrare con gli altri servizi di Azure permettendo di acquisire dati da stoage di dati sul cloud, usare la potenza di calcolo del cloud per eleborarli e alla fine salvare il risultato all’interno di un altro data store.
Azure Databriks

E’ una piattaforma cloud di analytics costruita su Apache Spark, ottimizzata per grandi quantità di dati, data science e SQL analytics. Inoltre si basa su formati open-source lakehouse come per esempio Delta Lake.
Databriks fa parte dei managed services su Azure.
Microsoft Purview

E’ un servizio che permette di gestire la governance dei dati su tutto lo stream aziendale. Si può utilizzare per creare una mappa dei propri dati e tracciare come i dati nascono e si spostano all’interno della propria organizzazione e fra vari applicativi / sistemi. Si possono anche definire policy e permessi sui dati condivisi fra diversi applicativi / sistemi.
Azure Data Lake Storage Gen2
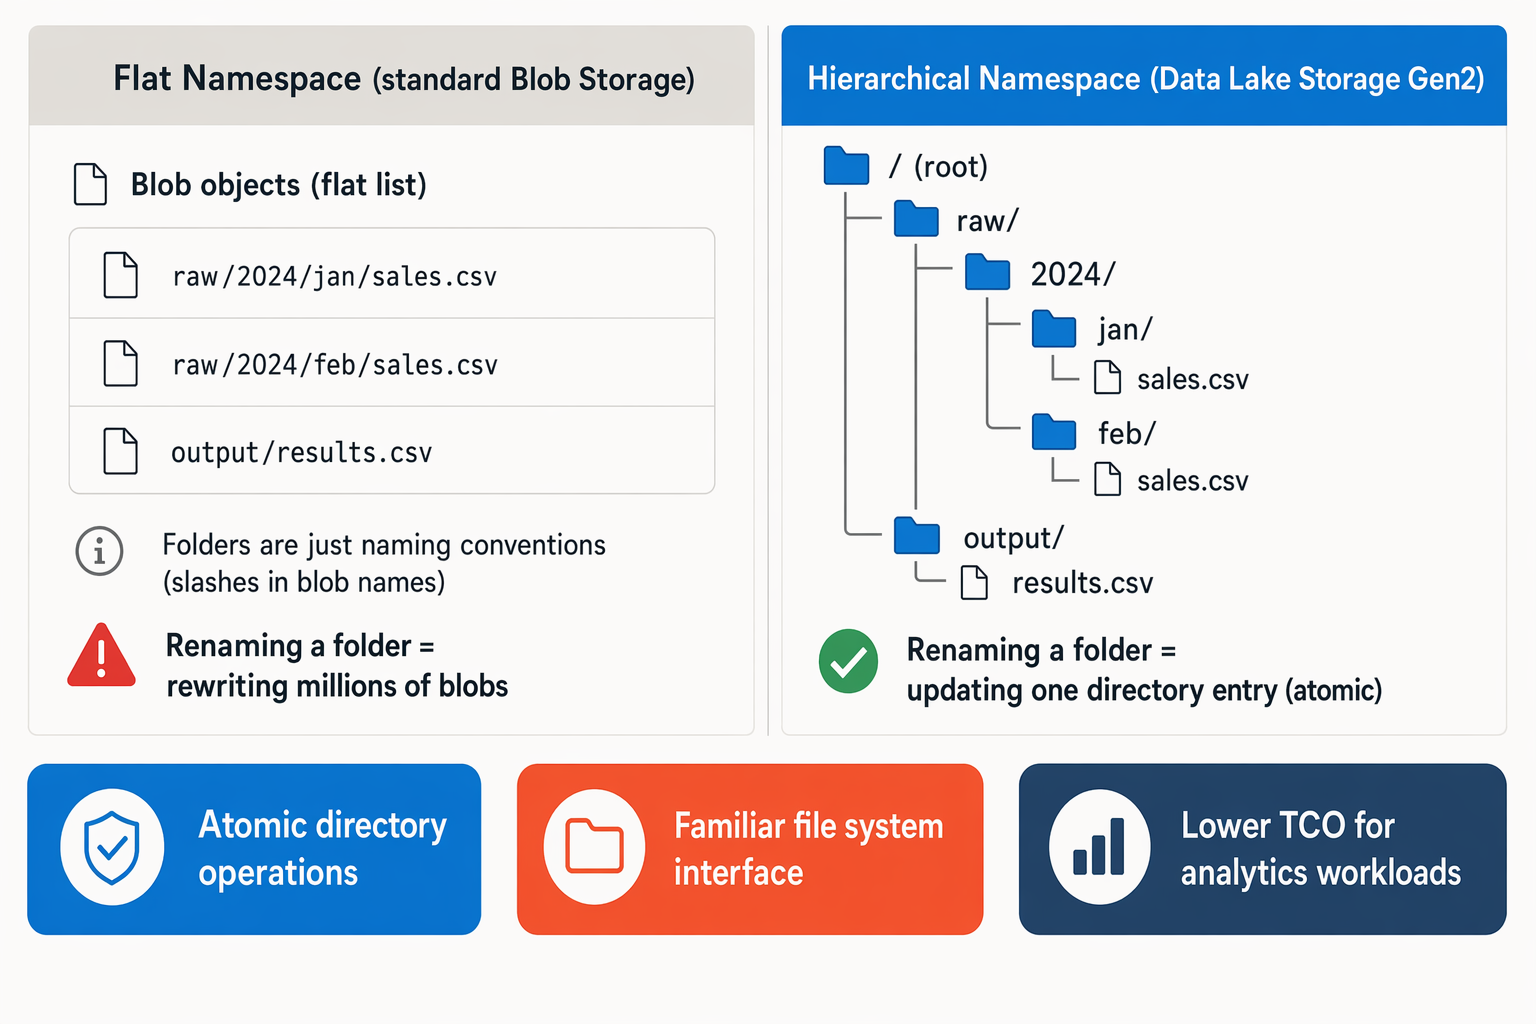
E’ una soluzione data lake basata utilizzata in Azure che combina i la scalabilità e i costi di Azure Blob Storage con un file system gerarchico che è compatibile con i principali sistemi di analytics.
Databricks può collegarsi ai dati contenuti in Azure Data Lake Gen2 e processarli, inoltre i tenant Microsoft Fabric eseguono automaticamente il deploy di OneLake che è basato su questa tecnologia. I namespace gerarchici permettono di definire i permessi in modo granulare andando a indicare le autorizzazioni di lettura/scrittura e esecuzione direttamente sui singoli file o cartelle.
Per creare un Azure Data Lake Storage Gen2 si deve abilitare l’opzione hierarchical namespace nelle impostazione dell’Azure Storage account.
Architettura data warehousing
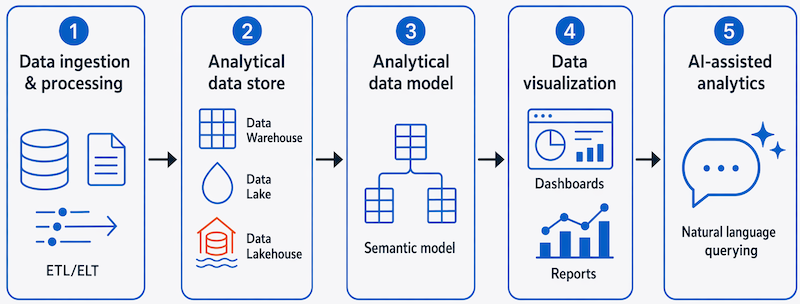
L’architettura varia a seconda di come variano le tecnologie sottostanti ma tipicamente includono i seguenti elementi:
Data ingestion ed elaborazione
Vengono prelevati i dati da più sorgenti (possono essere DB relazionali, files, stream in real time) e caricati dentro un data lake o un data warehouse relazionale. L’operazione di caricamento può essere di due tipi
- ETL - Extract, Trasform e Load
- ELT - Extract, Load e Transform
Indipendentemente dalla modalità scelta, il dataset risultante è ottimizzato per eseguire query e analisi su questi dati. L’elaborazione dei dati viene eseguita da sistemi che possono processare grandi volumi di dati in parallelo. La fase di data ingestion può avvenire sia come esecuzione batch di dati statici che elaborazione real time di stream di dati.
Analytical data store
Questi store includono data warehouses relezionali, data lakes basati su file-system e architetture ibride che combinano le funzionalità dei data warehouses e dei data lakes (ossia i data lakehouses).
Analytical data model